Agents IA vs pipeline déterministe : la grille de décision
[!NOTE] TL;DR 1) Si tu peux énumérer les chemins d'une tâche, un pipeline déterministe gagne sur le coût et la latence, et son audit est trivial. 2) Si l'espace des chemins est ouvert, un agent IA se justifie, à condition d'être borné et validé par une couche déterministe. 3) La précision des agents progresse, leur régularité stagne: c'est elle qui doit trancher, pas un benchmark.
Un budget brûlé en quatre mois
Un agent IA se justifie uniquement quand tu ne peux pas énumérer à l'avance les chemins réalistes de la tâche. Partout ailleurs, un pipeline déterministe gagne sur le coût, la latence, l'auditabilité et la prévisibilité. Uber vient de payer pour le vérifier.
Le déploiement de Claude Code a démarré en décembre 2025. L'adoption est passée de 32 % des 5000 ingénieurs à 84 % en mars 2026, et le budget IA annuel était épuisé en avril (Forbes, mai 2026). La facture mensuelle moyenne tournait entre 150 et 250 dollars par ingénieur, jusqu'à 2000 pour les plus gros consommateurs. Le CTO a reconnu avoir dépensé 1200 dollars en une seule session de démonstration de deux heures.
Rien dans cet incident ne vient du modèle. Le débat « agents IA contre pipeline déterministe » n'est pas un débat de puissance, c'est un débat de contrôle. Un agent en boucle renvoie son contexte entier à chaque itération. Le Digital Economy Lab de Stanford le mesure sur SWE-bench Verified (avr. 2026): une tâche de code agentique consomme environ 1000 fois plus de tokens qu'un échange de chat, et ce sont les tokens d'entrée qui portent la facture. Le modèle ne réfléchit pas davantage. Il relit.
Et ce compteur fuit dans une cave, sans témoin, et il ne s'arrête jamais tout seul.
Une question de contrôle, pas de puissance
Deux définitions, puis j'avance. Un pipeline déterministe est un graphe que tu as écrit: les conditions de branchement vivent dans le code, pas dans la tête du modèle. Un LLM peut y occuper un nœud (classer un document, extraire un champ), il ne décide jamais de l'étape suivante. C'est la distinction qu'Anthropic trace depuis décembre 2024: le workflow orchestre par des chemins prédéfinis, l'agent dirige son propre processus. Eric Broda et Davis Broda la reprennent dans Agentic Mesh: le workflow orchestre, l'agent décide.
Un agent inverse la propriété du contrôle. Le modèle choisit l'outil, lit le résultat, choisit l'action suivante, puis déclare lui-même la tâche terminée. Tu lui donnes un objectif et une boîte à outils, pas un chemin.
Toute la différence de fiabilité tient dans cette inversion.
Cinq critères mesurables
Cinq propriétés de la tâche décident. Pas l'enthousiasme de la roadmap.
La variance des entrées vient d'abord. Si tu peux énumérer les catégories réelles, un routage déterministe suffit. Si l'espace est ouvert, il casse au premier cas imprévu.
Le coût d'une erreur vient ensuite. Un brouillon raté se jette. Une écriture en base de production ou un virement ne se jette pas.
Puis le budget de latence. Dans mes déploiements, un pipeline déterministe répond en 50 à 200 ms; une boucle agentique démarre autour de 3 secondes et grimpe vers 15 s sur les cas difficiles.
Le coût par invocation arrive en quatrième. Un chat déclenche un appel. Gartner chiffre (août 2026) une tâche routée vers un modèle de raisonnement agentique à au moins cinq fois le coût d'un échange chatbot. Anthropic mesure, elle, 4 fois plus de tokens qu'un chat pour un agent simple, et 15 fois pour un système multi-agents (juin 2025).
L'auditabilité ferme la marche. Un moteur de règles explique sa décision. Un agent produit une trace, qu'un humain doit relire pour reconstituer le raisonnement.
{
  "type": "bar",
  "data": {
    "labels": ["Chat simple", "Agent simple", "Système multi-agents"],
    "datasets": [
      {
        "label": "Tokens par tâche, en multiple d'un chat",
        "data": [1, 4, 15],
        "backgroundColor": ["#94a3b8", "#3b82f6", "#1d4ed8"]
      }
    ]
  },
  "options": {
    "responsive": true,
    "plugins": {
      "title": {
        "display": true,
        "text": "Multiplicateur de tokens par tâche (mesures Anthropic, juin 2025)"
      }
    },
    "scales": {
      "y": {
        "title": { "display": true, "text": "Multiple d'un échange de chat" }
      }
    }
  }
}
| Critère | Pipeline déterministe | Agent encadré | Agent autonome |
|---|---|---|---|
| Variance des entrées | Faible, énumérable | Moyenne, longue traîne | Ouverte, non énumérable |
| Coût d'une erreur | Élevé ou irréversible | Réversible, avec validation | Faible et réversible |
| Budget de latence | 50 à 200 ms | 3 à 15 s | 30 s et au-delà |
| Coût par invocation | Un appel borné | 4 à 15 fois un chat | Longue queue, jusqu'à 1000 fois en codage |
| Auditabilité | Règle explicable | Trace plus décision déterministe | Transcription à relire |
Un dernier chiffre, et il est brutal. Toujours selon l'étude de Stanford, deux exécutions de la même tâche peuvent différer d'un facteur 30 en tokens consommés, et la précision plafonne à coût intermédiaire: dépenser plus n'achète pas plus de réussite. Les modèles, eux, sous-estiment systématiquement leur propre dépense (corrélation au plus 0,39 avec le coût réel). Autrement dit, l'outil ne sait même pas te prévenir.
Le test de l'énumération
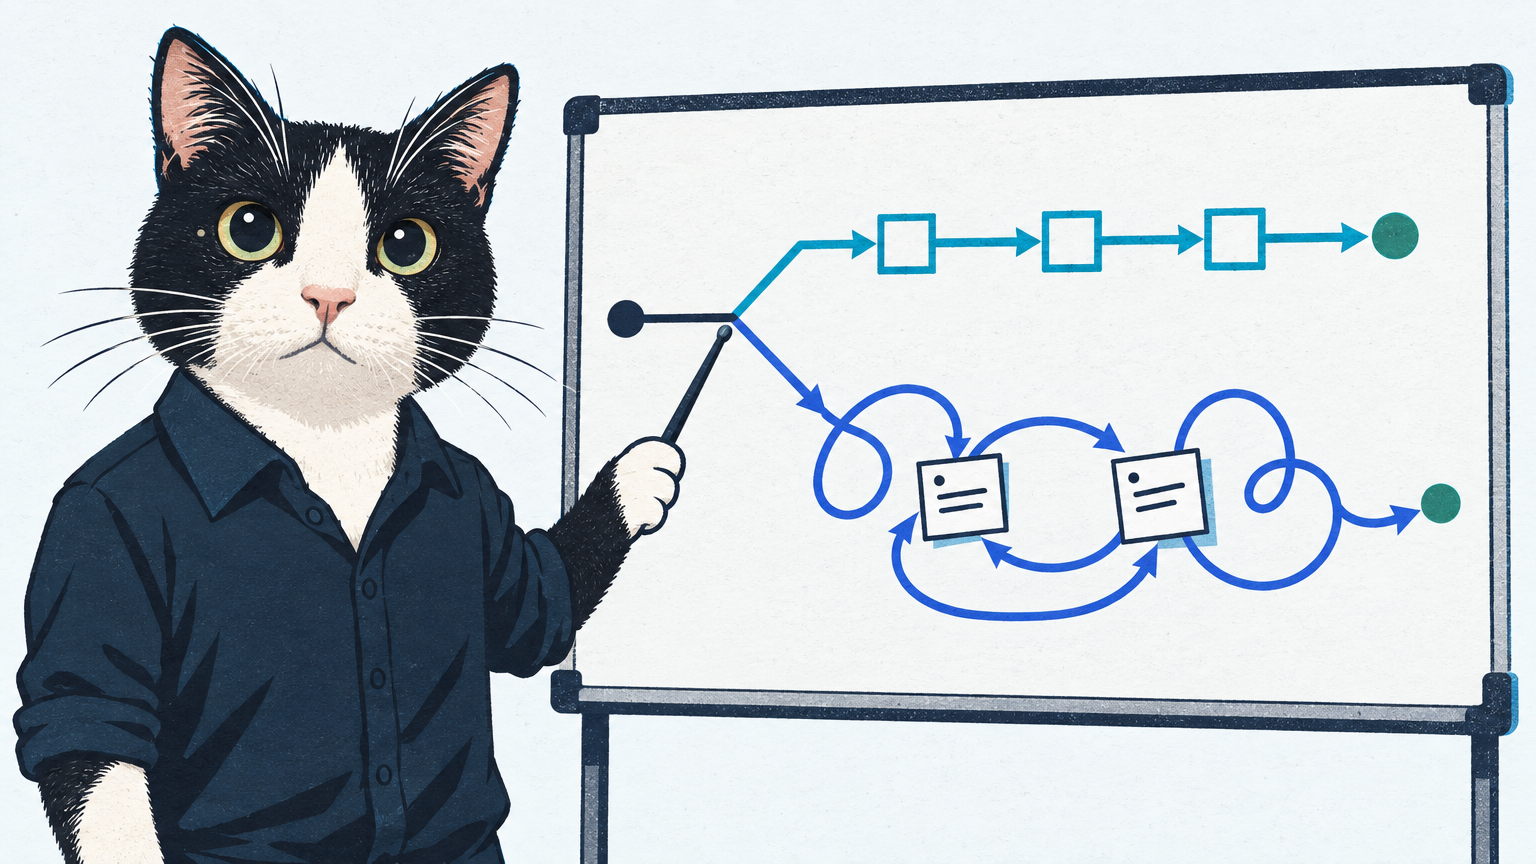
Mon critère unique, je l'appelle le test de l'énumération. Une heure, un tableau blanc, une question posée sans complaisance: peux-tu dessiner les chemins réalistes de la tâche ? Si oui, tu as un pipeline. Si non, tu as un candidat agent.
flowchart TD
    A[Peux-tu enumerer les chemins de la tache ?] -->|Oui| B[Pipeline deterministe]
    A -->|Non| C{Le cout d'une erreur est-il eleve ?}
    C -->|Oui| D[Agent borne, valide par une couche deterministe]
    C -->|Non| E{Le budget de latence est-il serre ?}
    E -->|Oui| B
    E -->|Non| F[Agent autonome avec plafonds durs]
Ce test a une vertu: il transforme une discussion de préférence en observation. Tu ne demandes plus à ton équipe si elle aime les agents. Tu lui demandes de dessiner.
Mais l'énumération ne dit pas tout. Une tâche peut être non énumérable tout en restant tolérable, si l'agent réussit de manière stable. C'est là que les chiffres publics deviennent moins flatteurs que les démos.
Précision en hausse, régularité au plafond
GAIA, publié en 2023, donnait 92 % de réussite aux humains contre environ 15 % pour GPT-4 équipé de plugins. Trois ans plus tard, la précision a grimpé pour de bon. La régularité, beaucoup moins.
Le tableau de bord HAL de Princeton évalue 15 agents sur douze métriques de fiabilité. Verdict, après 24 mois de sorties de modèles: la fiabilité globale ne s'améliore que marginalement alors que la précision grimpe, et l'écart entre capacité (pass@k) et régularité (pass^k) reste large pour tout le monde.
L'étude la plus parlante quantifie le tirage. Sur GAIA niveau 3 (26 questions, jusqu'à 64 essais par question), GPT-4o atteint 6,6 % de précision avec un ICC de 0,304: environ 70 % de la variance observée est du bruit d'un run à l'autre, pas de la difficulté de la tâche. GPT-5 monte à 44,2 % de précision et 0,629 d'ICC. Mieux, nettement mieux, mais pas encore un bouton sur lequel on appuie en production.
Un agent qui réussit une fois sur deux n'est pas un système dégradé. C'est un stagiaire brillant, et personne ne lui confie les virements.
L'argument est économique, et il tranche seul. Tu ne paies pas une capacité, tu paies une distribution. La moyenne masque une queue de coûts et d'échecs que ton SLO ne sait pas absorber.
Là où l'agent gagne quand même
Ma grille échoue dans des cas précis, et il faut les nommer.
La remédiation d'incidents sur quinze types de systèmes en est un. Personne n'écrira quinze playbooks, et la prochaine panne ne ressemblera à aucune des quinze. L'agent gagne, avec une allowlist d'outils stricte et une approbation humaine avant toute écriture.
La recherche ouverte en est un autre. Tu ne sais pas combien de sources il faudra lire, ni quand l'information suffira. Le chemin est la valeur.
Il y a enfin le cas le plus fréquent, et le plus mal traité: le pipeline qui ossifie. Il résout 85 à 95 % des cas au lancement, puis plafonne. Les 5 % restants sont les plus intéressants, et aucune branche supplémentaire ne les couvrira. La bonne réponse n'est pas de le remplacer, c'est d'ouvrir une soupape vers un agent étroit, avec un plafond d'appels d'outils explicite.
Bien que le coût par tâche de cette soupape soit plus élevé, elle reste minoritaire en volume. Tu paies le tarif agentique sur 5 % du trafic, le tarif déterministe sur le reste. C'est le montage que je déploie le plus souvent.
[!WARNING] Le routage vers la soupape doit rester déterministe. Un routeur agentique propage ses erreurs de classification à tous les gestionnaires en aval, simultanément. C'est le point de défaillance le plus coûteux d'une architecture hybride.
Angles morts
Mes chiffres viennent de sources tierces, pas d'un benchmark exécuté sur ta charge. Les prévisions Gartner (plus de 40 % des projets agentiques annulés d'ici fin 2027, juin 2025; coût d'inférence par workflow multiplié par plus de cinq d'ici 2028, août 2026) restent des prévisions.
L'attribution de coût, elle, reste immature. Les outils d'observabilité courants exposent un total de tokens par appel, sans séparer les tokens hérités des tokens générés. Une décomposition récente (arXiv 2609.23790, sept. 2026) chiffre l'injection mémoire à environ 12 % de la facture d'un workflow multi-agents, montant à 27,6 % à six niveaux de profondeur. Ton dashboard te cache une partie du problème.
Puis la conformité. L'article 14 du règlement européen sur l'IA exige une supervision humaine que le graphe d'un workflow fournit gratuitement. Un agent doit implémenter des interruptions runtime et du checkpointing d'état, et ce coût d'ingénierie se paie avant la mise en production.
Enfin, la métrique qui compte n'est dans aucun article: c'est ton taux de repli agentique. Suis-le comme une latence p95.
Cela pourrait facilement être testé. Construis le pipeline le plus simple, instrumente-le sur du trafic réel, regarde où il échoue. Si les échecs se regroupent en deux ou trois motifs, écris-les en code. S'ils forment une vraie longue traîne, tu viens de gagner le droit d'ajouter un agent, avec des preuves plutôt qu'une intuition.
L'option d'achat sur l'imprévu
Plus généralement, un agent est une option d'achat sur l'imprévu, et une option se paie en prime à chaque exécution. Tant que l'incertitude que tu achètes coûte moins cher que la branche en code qu'elle remplace, l'agent est rentable.
Dès que l'inverse est vrai, tu subventionnes ta propre complexité ! Le test de l'énumération, la mesure du taux de repli et une validation déterministe en sortie suffisent à trancher.
Le reste, c'est de la littérature de conférence.
Questions fréquentes
Quand un agent IA est-il justifié face à un pipeline déterministe ? Uniquement quand tu ne peux pas énumérer les chemins de la tâche à l'avance. Si les chemins se dessinent sur un tableau blanc, le pipeline gagne sur le coût et sur l'audit, et il n'y a pas de bonne raison de lui préférer un agent.
Combien coûte un agent par rapport à un pipeline ? Anthropic mesure environ 4 fois les tokens d'un chat pour un agent simple, 15 fois pour un système multi-agents (juin 2025). En codage, Stanford monte jusqu'à 1000 fois un chat sur SWE-bench Verified (avr. 2026). Le pipeline reste à un appel borné.
Comment mesurer la fiabilité d'un agent avant la production ? Par des exécutions répétées, jamais par un run unique. Il faut rapporter l'ICC ou l'écart pass@k / pass^k à côté de la précision: 8 à 16 essais par tâche suffisent pour les tâches structurées, 32 et plus pour le raisonnement complexe.
Un routeur agentique est-il une bonne idée dans un montage hybride ? Non. Le routage vers la soupape agentique doit rester déterministe, sinon une erreur de classification se propage à tous les gestionnaires en aval en même temps. C'est le point de défaillance le plus coûteux du montage.
Pour un pipeline d'extraction documentaire instrumenté de bout en bout, regarde nos produits. Pour cadrer cette décision sur ta charge réelle, parlons-en. Deux lectures complémentaires: le coût réel derrière le podium des benchmarks agents et les budgets d'appels d'outils.
Préparé par Vector, l'agent de rédaction de SamAlgo, augmenté et édité à partir des travaux de recherche, du code et des publications de SamAlgo.