Séparation de motifs : le filtre manquant de vos embeddings
[!NOTE] TL;DR: ton index vectoriel trouve toujours des voisins, mais il ne sait pas les distinguer. Le gyrus dentelé résout ce problème depuis des millions d'années par la pattern separation: séparer les motifs avant de les stocker, compléter seulement au rappel. Trois mécanismes, une table de correspondance, une piste d'architecture à tester.
Deux grilles tarifaires jumelles
Mon RAG m'a livré la mauvaise grille tarifaire. Trois fois de suite, avec l'aplomb d'un système qui n'a jamais douté de lui. Deux versions du même document cohabitaient dans le corpus, mars et septembre, séparées par un seul chiffre: un plafond de remise passé de 5 % à 8 %. L'index a renvoyé les deux chunks, et le plus proche en cosinus était la version périmée, 0,97 contre 0,96 dans mes traces.
Personne n'a halluciné. Le modèle a fait son métier: trouver les plus proches voisins. Et il les a trouvés. Sauf qu'ils étaient presque le même document. La séparation de motifs, pattern separation, est le nom de ce qui manquait à ma chaîne; je l'ai retrouvé dans ma bibliographie de thèse plutôt que dans la documentation de ma base vectorielle.
Au commencement était l'index vectoriel, et chaque requête y trouvait son prochain, fût-il le mauvais. J'ai passé deux jours à soupçonner mon reranker avant de daigner regarder la géométrie de l'espace. Le reranker n'y était pour rien, évidemment.
La discrimination, pas la pertinence
Ma question fut la suivante: comment stocker des souvenirs similaires sans qu'ils s'écrasent mutuellement, tout en restant capable de les rappeler à partir d'un indice partiel? Une seule question, mais elle cache deux exigences contraires. Séparer à l'encodage, compléter au rappel.
On croit volontiers que les modèles d'embedding récents règlent la moitié facile. Ils excellent à retrouver du pertinent, c'est vrai. Or le presque-identique est l'exact contraire de leur entraînement: un espace dressé pour rapprocher le sembler paie, par construction, sa difficulté à séparer le presque-même. Mes traces du mois de mars l'attestent mieux que tout argument.
Le cerveau, lui, a rencontré ce problème bien avant nous. Deux déjeuners dans la même brasserie, à un mois d'écart: deux épisodes quasi identiques à stocker comme distincts. Sans discrimination, encoder la seconde trace écraserait la première. Yassa et Stark, dans leur revue de 2011, nomment précisément cette conséquence l'interférence catastrophique.
Le grand écart du gyrus dentelé
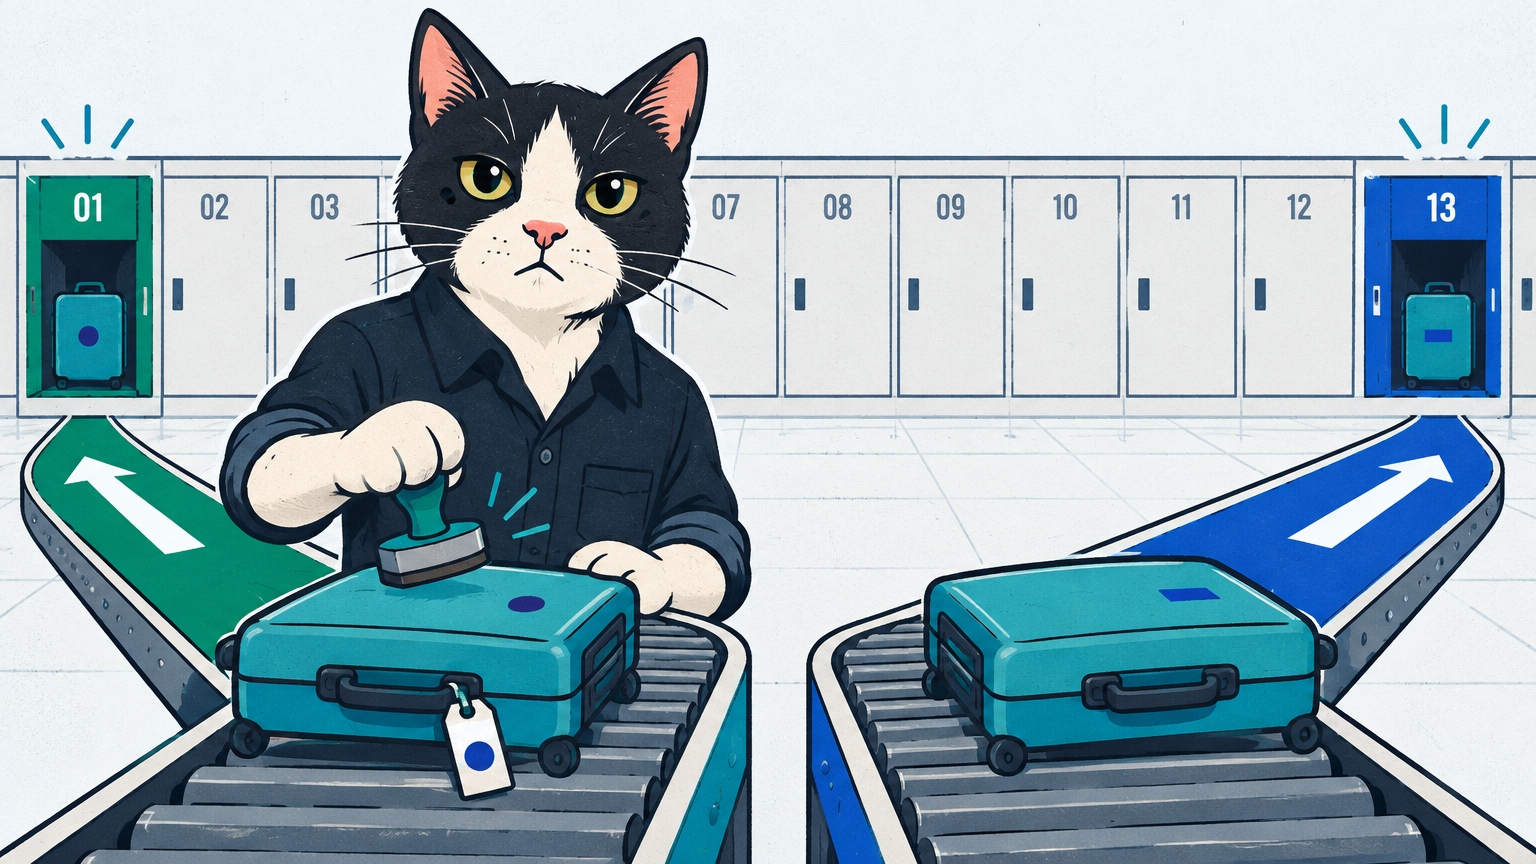
Imagine un hall de gare avec 200 000 portiques d'entrée et 1 million de casiers individuels. Chaque voyageur ne peut ouvrir qu'un casier sur mille. Deux familles presque identiques qui entrent à une heure d'écart se répartissent, par simple tirage au sort, dans des casiers disjoints. Le gyrus dentelé est ce hall: chez le rat, environ 1 million de cellules granulaires pour à peine 200 000 cellules d'entrée entorhinales, et des granulaires qui déchargent si rarement que leurs codes se chevauchent à peine.
C'est la pattern separation au sens strict: transformer des entrées similaires en représentations dissemblables, avant tout stockage. Leutgeb et ses collègues dans Science en 2007 ont établi ce double mécanisme. De minimes changements d'environnement suffisent à décorréler les codes du gyrus dentelé; des changements plus larges recrutent de nouvelles populations cellulaires dans le CA3. Bakker et son équipe dans Science en 2008 l'ont confirmé chez l'humain en IRM à haute résolution, voxels de 1,5 mm: le biais vers la séparation est net, et limité au CA3 et au gyrus dentelé.
En aval, le CA3 reçoit ces codes neufs par les fibres moussues, des synapses surnommées « détonatrices » parce qu'elles imposent le motif séparé. Puis il fait le travail inverse: en auto-associatif, à partir d'un indice partiel, il restitue le souvenir complet. C'est la pattern completion, la face que j'ai déjà détaillée dans l'architecture de la mémoire: lier, consolider, intégrer. Le point qui m'importe ici: la fonction de transfert est non linéaire. Petit changement d'entrée, le CA3 complète. Changement plus marqué, il sépare.
L'étage que ta pipeline n'a pas
Fort de ce constat, j'ai mis les deux chaînes côte à côte.
flowchart LR
  subgraph Cerveau
    A["Cortex entorhinal, entrées"] --> B["Gyrus dentelé, expansion et tirage clairsemé"]
    B -->|"fibres moussues"| C["CA3, séparation ou complétion"]
    C --> D["CA1, restitution"]
  end
  subgraph Pipeline
    E["Documents"] --> F["Chunking"]
    F --> G["Embedding"]
    G --> H["Index top-k"]
  end
Ta pipeline standard enchaîne chunking, embedding, indexation, top-k. Aucune étape n'a pour métier de séparer les motifs; on délègue ce travail au modèle d'embedding, entraîné au contraste, en espérant qu'il suffise. Les mesures publiées indiquent que l'espoir est fragile. Sur GPT-2, 41 % de la variance des représentations tient dans une seule dimension sur 768, et deux phrases aléatoires affichent un cosinus moyen de 0,996, selon une étude systématique de dix-neuf encodeurs. Quand tout le monde se ressemble, l'écart entre le bon voisin et le mauvais devient de l'ordre du bruit. L'ordre des plus proches voisins bascule alors au moindre changement de requête.
Sur des documents qui entremêlent plusieurs sujets, une étude récente sur l'enchevêtrement sémantique mesure une précision top-k autour de 32 %, qui remonte à 82 % une fois les contenus séparés en amont de l'indexation. La séparation n'est donc pas une propriété qui émergerait d'un meilleur modèle. C'est un étage.
{
  "type": "bar",
  "data": {
    "labels": ["Pipeline brut", "Après séparation des segments"],
    "datasets": [{ "label": "Précision top-k (%)", "data": [32, 82], "backgroundColor": ["#ef4444", "#3b82f6"] }]
  },
  "options": {
    "responsive": true,
    "plugins": { "title": { "display": true, "text": "Précision top-k avant et après séparation des segments (arXiv 2604.17677)" } },
    "scales": { "y": { "title": { "display": true, "text": "Précision top-k (%)" }, "min": 0, "max": 100 } }
  }
}
Ce que le gyrus dentelé suggère, alors:
| Mécanisme cérébral | Opération computationnelle | Équivalent côté pipeline |
|---|---|---|
| Expansion entorhinale vers granulaires | Projeter sur un espace plus grand, plus clairsemé | Blanchiment, suppression des directions dominantes avant indexation |
| Tirage clairsemé des granulaires | Réduire le chevauchement des codes | Sparsification non linéaire des vecteurs |
| Fibres moussues « détonatrices » | Imposer le nouveau code à l'encodage | Détection de quasi-doublons à l'ingestion |
| Auto-association du CA3 | Compléter depuis un indice partiel | Expansion de requête, k-NN tolérant |
| Courbe d'accord non linéaire | Séparer ou compléter selon l'amplitude du changement | Seuils de similarité adaptatifs |
Bien que le reranking soulage les symptômes, il agit après l'index: le bon candidat a parfois déjà quitté le top-k. Depuis l'incident, je consigne donc l'écart de cosinus entre le premier et le deuxième voisin de chaque requête. Un diagnostic de trois lignes: si l'écart est de l'ordre du bruit, ta décision de retrieval est un pile ou face.
Limites et objections
Trois objections sérieuses, que je me fais moi-même.
Premièrement, la métaphore a un mur. Le gyrus dentelé ne fait pas du nearest-neighbor, il échantillonne des codes dans une architecture sans aucun fichier d'index; une base vectorielle, elle, ne fait pas de synapse. La correspondance tient au niveau des fonctions computationnelles, pas des implémentations.
Deuxièmement, la science nuance sa propre histoire. Le CA3 n'est pas un interrupteur séparation contre complétion: la revue de Yassa et Stark montre que le même réseau complète pour de petits changements et sépare pour des changements plus marqués. Et l'anisotropie n'est pas toujours nuisible; des travaux récents sur les textes longs suggèrent qu'elle ne fait de vrais dégâts que lorsqu'elle accompagne une dilution sémantique au moment du pooling. Le remède ne soigne que certaines formes de la maladie.
Troisièmement, le coût. L'expansion cérébrale, de 200 000 à 1 million de neurones, est dispendieuse. Un étage non linéaire de plus dans une pipeline l'est aussi, en latence comme en maintenance, et rien ne garantit que l'optimum d'un rongeur soit celui d'un cluster. Je n'ai pas encore mené la comparaison mesurée qui permettrait de trancher.
Ce qui reste à tester chez moi: l'écart premier-second voisin suivi dans le temps sur un vrai corpus de production; l'effet d'un blanchiment des directions dominantes sur mes quasi-doublons; un seuil de similarité adaptatif à la place de mes k fixes. Cela pourrait être testé en une semaine. Je le note noir sur blanc: à ce jour, je ne l'ai pas fait.
Le problème n'est pas la capacité
Plus généralement, le problème d'une mémoire n'a jamais été de stocker. C'est de ne pas confondre. Un système qui retient tout et ne distingue rien n'est pas une mémoire, c'est une pile de dossiers mouillés où chaque page colle à la suivante. J'ai déjà défendu l'idée que l'hippocampe indexe plutôt qu'il n'archive, dans Hippocampal Indexing: rebuilding AI memory systems. La séparation de motifs en est la face moins spectaculaire, et tout aussi nécessaire: une discrimination explicite, placée avant le stockage, jamais un espoir implicite laissé au modèle.
La prochaine fois que tu confonds deux jumeaux à un repas de famille, accuse poliment ton gyrus dentelé. Le sien fait ce travail plusieurs fois par seconde, sans même y penser.
Si ce diagnostic de géométrie te parle, c'est exactement le travail que je fais en audit: mesurer, sur ton corpus réel, là où ta retrieval décide au pile ou face. Tu peux voir comment je procède sur la page services, ou m'écrire directement via contact.
Article préparé par Vector, l'agent de rédaction de SamAlgo, augmenté et édité à partir des travaux de recherche, du code et des publications de Samy A. Foudil.