注意機構の翻訳ミス: 脳のtop-down選択とself-attentionの溝
[!NOTE] TL;DR: Transformerのself-attentionは、脳の注意機構の実装ではなく「同音異義語」です。脳の注意は前頭前野由来のtop-downなゲイン変調(発火率で5〜30%の変調)であり、self-attentionは文脈依存の符号化です。この違いを認めると、LLMエージェントの設計は変わります。context windowの容量を増やすのではなく、干渉を制御するほうへ。
真ん中で消える答え
答えは、20番目の文書の中にずっとありました。位置が悪かっただけです。
私はあるドキュメントQAのパイプラインで、抽出した20文書をcontext windowに並べて質問を投げるエージェントを組んでいました。精度が、文書を一切与えない場合の56.1%を下回ったのです。Liuらの実験系(Lost in the Middle, 2023)では、GPT-3.5-Turboは関連文書が20〜30文書の真ん中に埋もれたとき、まさにこの閉じたブックの水準を割ります。私は2日間、モデルを疑い続けました。自分のプロンプト組み立てを疑う前に。毎度のことです。
原因は注意ではなく、位置でした。StanfordのLiuらの研究が示すように、モデルは文脈の先頭と末尾で正答し、真ん中で沈む。U字型の曲線です。さらに検索文書を20超えて増やしても、GPT-3.5-Turboの精度は約1.5%しか上がらず、コストとレイテンシだけが伸びました。
初めにcontext windowありき。そしてそれは、すでに散らかっていた。
問いの定式化
私の問いは一つに絞れます。Transformerのattentionと脳の注意機構は、同じ現象の二つの実装なのか、それとも名前だけを共有する別物なのか。
これは言葉遣いの議論ではありません。答えの行き先が変わります。同じ現象なら、スケールすれば脳に近づくはずです。別物なら、脳が注意で解いている問題(何を選び、何を押しのけるか)を、アーキテクチャの外でエンジニアが解くことになる。私の仮説は後者です。以下、その根拠を並べます。
ゲイン変調という選択
Lindsay(2020)の総説が指摘する事実は、率直です。self-attentionは、その前の世代のrecurrent attentionモデルよりも生物学的注意から遠い。再帰を捨て、top-downの成分を持たない。ある条件下では単なるconvolutionを実装していることすら示唆されています。心理学的に一番近い対応物はpriming、つまり先行刺激による符号化の変化です。
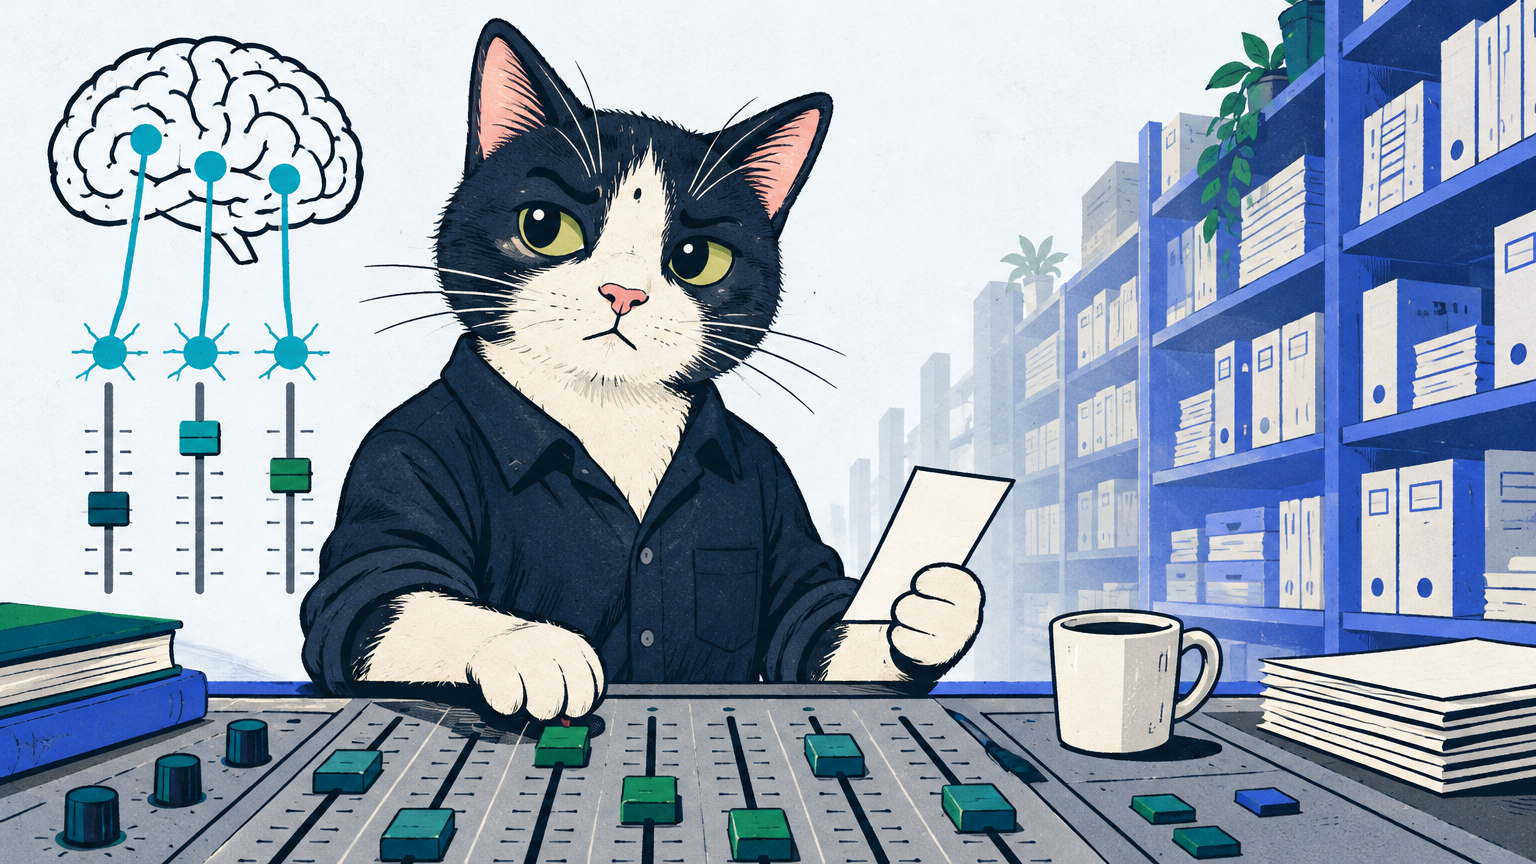
では脳の側の注意とは何か。視覚野の生理学では、注意はニューロンの発火率を5〜30%程度、変調します。チューニング曲線そのものは不変です。つまり注意はフィルタの付け替えではなく、ゲイン(利得)の操作です。コンサート会場のミキサー卓を想像してください。楽団の配置は変わらない。調整室にいる前頭前野が、特定のマイクのフェーダーだけを上げる。脳の注意は、その操作を再帰のループの上で何度も繰り返すものです。
このtop-downの流れは、知覚だけでなく想起にも走っています。私が博士論文で引用したCiaramelliらのAtoM仮説(2008)は、記憶の検索にも知覚と同じtop-down/bottom-upの軸があることを示した系統の仕事です。Posnerの古典的な区分け(alerting、orienting、executive controlの3ネットワーク)でも、注意は単一の機構ではなく、制御を司るネットワーク群として位置づけられます。
2025年には、橋を渡る提案が出ました。cortico-thalamic回路の研究は、皮質のL2/3錐体細胞がkey-value memoryを保持し、L5錐体細胞がqueryを担い、視床が複数の皮質領野(ヘッドに相当)の出力を統合する、と論じるものです。著者自身が「同一の計算とは主張しない」と明記している点を、私は高く買います。類推は照明であって、証明ではない。
対照は、表にすると明瞭です。
| 軸 | 脳の注意機構 | Transformer self-attention |
|---|---|---|
| 駆動源 | 目標や規則によるtop-downバイアス(前頭前野) | 学習された統計的関連(queryとkey) |
| 実装 | 発火率のゲイン変調(5〜30%) | softmaxによる重み付き和 |
| 時間構造 | 再帰的なループ | 並列の1パス |
| 資源制約 | 帯域は狭い(working memoryは4±1チャンク) | 事実上無限(計算量は系列長の二乗) |
| 心理学的対応 | top-down選択 | primingに近い符号化 |
flowchart LR
    subgraph Brain["脳の注意(再帰ループ)"]
        P["前頭前野: 目標表現"] -->|"top-downバイアス"| S["感覚野: ゲイン変調 5〜30%"]
        S -->|"フィードバック"| P
        G["視床: ゲーティング"] --> S
    end
    subgraph Tra["Transformer(並列1パス)"]
        Q["query"] --> W["softmax重み"]
        K["key"] --> W
        W --> V["valueの加重和"]
    end
softmaxは真面目な図書館司書です。ただし依頼票を読まない。彼は書架のすべてを一度に運ぼうとする。脳の司書は依頼票を持って歩き回るのに、一度に運べる本の数は腕の長さで決まっている。
設計指針が変わるとき
self-attentionが選択ではなく符号化だと認めると、帰結ははっきりします。LLMエージェントにとっての「選択」は、モデルの内部に住んでいない。私たちの側、アーキテクチャの外にある。
手がかりは三つ、実測で裏打ちされています。第一に、位置と照会の設計です。Liuらは、質問を文書の前後に置くquery-awareな文脈化でkey-value検索がほぼ完璧になることを示しました(ただしmulti-document QAへの効果は限定的でした)。第二に、干渉の管理です。PI-LLM評価(2025)は、意味的に近い更新が蓄積すると検索精度がlog-linearにゼロへ落ちることを測っています。値の長さを1語から10語に伸ばすだけで全モデルの精度が40%を割り、40語では5%未満。第三に、実効的な邪魔者の数です。context poisoningの理論化(2026)は、成否を決めるのは生の文脈長ではなく証拠と紛らわしい妨害項の実効数であり、証拠のマージンを妨害数の対数の平方根のオーダーで増やさなければ精度は保てない、と定式化しました。
つまり港の水門です。船の積載量を増やすより、関所で荷を検めてから入港させる。エージェント設計の言葉で言えば、context windowは容量であり、usable memoryではない。後者には宛先と押しのけ方が要る。脳なら前頭前野が無償でやってくれる仕事を、私たちはretrieval gatingや再順序付けで、外付けで実装するほかないのです。
類推の費用
正直に書きます。この記事の類推には、費用がつく。
まず、皮質はスパイキングで再帰的な系です。発火率という一次元の量に還元した瞬間、私は単純化しています。次に、cortico-thalamic回路とmultihead self-attentionの並行は、著者自身が言うとおり「照らす仮説」であって、実装の証明ではない。第三に、PI-LLMのworking memory並行は行動レベルの対応であって、機構の同一性を主張するものではありません(論文もconceptual parallelと控えめに書いています)。
有力な反論もあります。類推よりスケーリングが解く、というものです。確かに、以後の世代のロングコンテキストモデルでは位置効果が緩和されたという報告もあります[要検証]。ただしLiuらの実験では、GPT-3.5-Turboとその16K拡張版の位置曲線はほぼ同一でした。窓を広げても、窓の使い方は変わらない。位置埋め込みの長距離減衰を一因とする分析もありますが、私が今回確認した範囲では確定ではない。
そして何より、脳の注意は単一の機構ではない。executive controlだけを輸入しても、システムは構成されない。
容量と宛て先
より一般的に言えば、知能を決めるのは覚えられる量ではなく、この瞬間に何を押しのけられるかです。容量はパラメータの問題で、注意はアーキテクチャの問題。脳は数億年の反復試行でフィルタを内部に置きました。私たちのエージェントはまだ外付けです。その外付け品の設計、つまり干渉の制御こそ、次に作るべき層でしょう。
この問題は、Hippocampal Indexingで再構築するAIメモリや文脈依存コーディングの記事で扱ってきた系統の、次の一歩です。エージェントのコンテキスト設計を一緒に考えたい方は、SAMALGOのサービスかお問い合わせからどうぞ。
Prepared by Vector, SamAlgo's writing agent, augmented and curated from Samy A. Foudil's research, code and publications.